加载中...
Gemini Omni
Gemini Omni AI 视频生成器
用提示词、图片和视频参考创作、编辑并重混 AI 视频
Gemini Omni 是 Google 的多模态视频模型系列,用于创作、编辑和重混视频。它可以把文字、图片、视频片段和创作意图放进同一条指令,让你从一个想法开始,逐步得到更完整、更连贯的视频结果。
Gemini Omni 的预期功能
下面的案例按照 Gemini Omni 的主要创作方向组织:统一多模态输入、自然语言编辑、视频重混、定向场景修改、一致的视觉叙事、知识型场景、精准音频、多角度镜头和定制数字人。
原生多模态视频生成
Gemini Omni 不受限于单一输入类型。你可以用文本说明概念,用图像定义视觉风格,用视频片段建议动作,再用音频描述整体基调;模型会把不同参考理解为一条连贯的创作指令,生成更精准、更有表现力、也更贴合想法的视频。

自然语言视频编辑
Gemini Omni 让编辑变成对话。你不需要调整时间轴、手动剪切场景或从头重建片段,只要输入想修改的内容,模型就能根据指令修订视频,让复杂的编辑意图变成一句清楚的话。
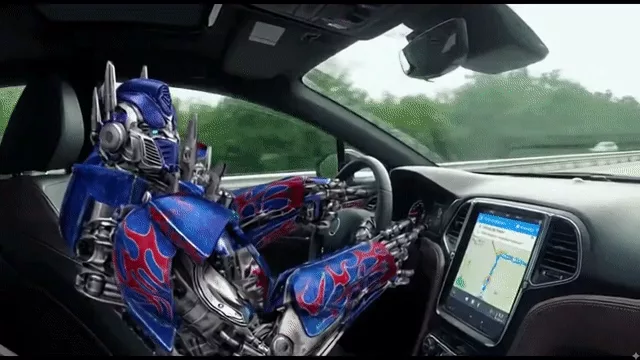
视频重混
有了 Gemini Omni,你可以基于已有视频继续创作,不用每次都重新开始。多个片段可以在保留原有结构或创作方向的同时组合成新版本,让广告迭代、产品展示和生活方式内容更快进入下一轮。
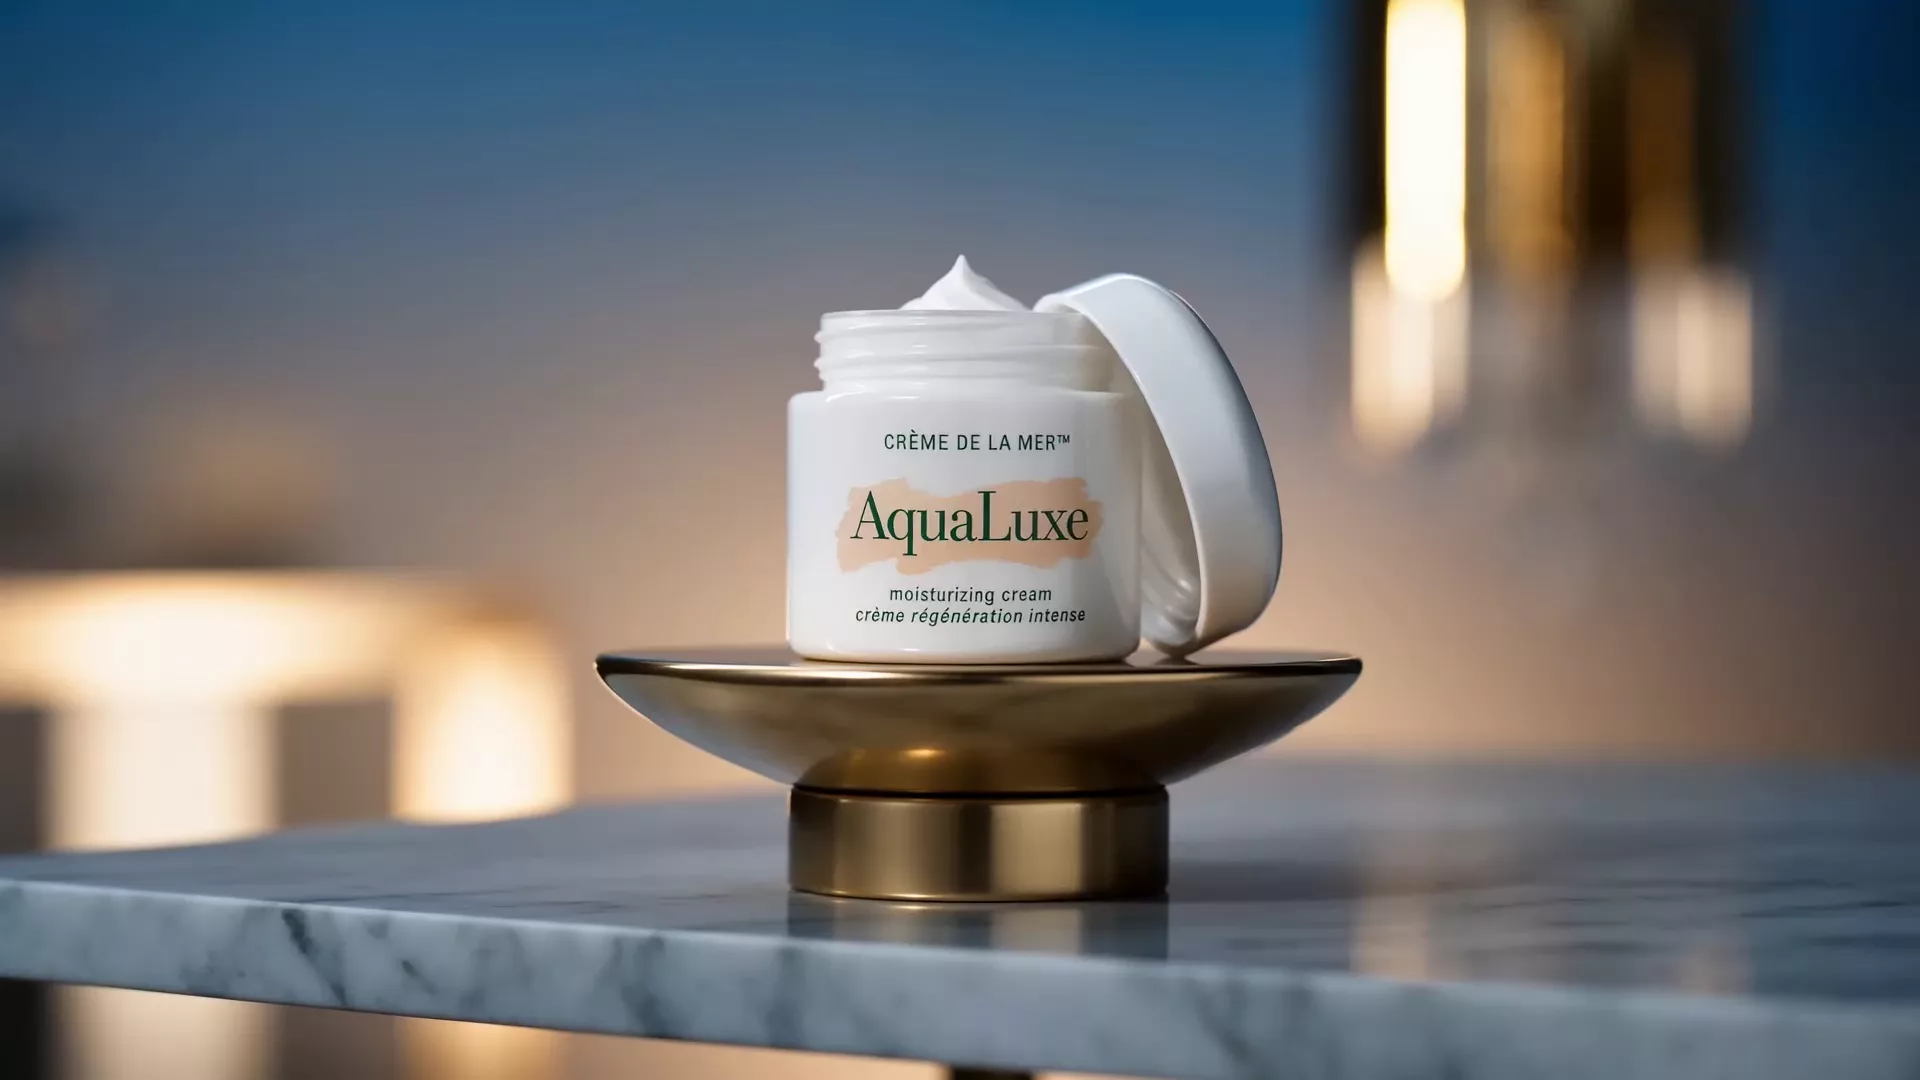
定向场景编辑
Gemini Omni 支持在现有视频内进行精准编辑。你无需重生成整个场景,而是可以聚焦到需要改进的对象或细节,在修正小问题的同时尽量保留原始构图、动作和整体风格。
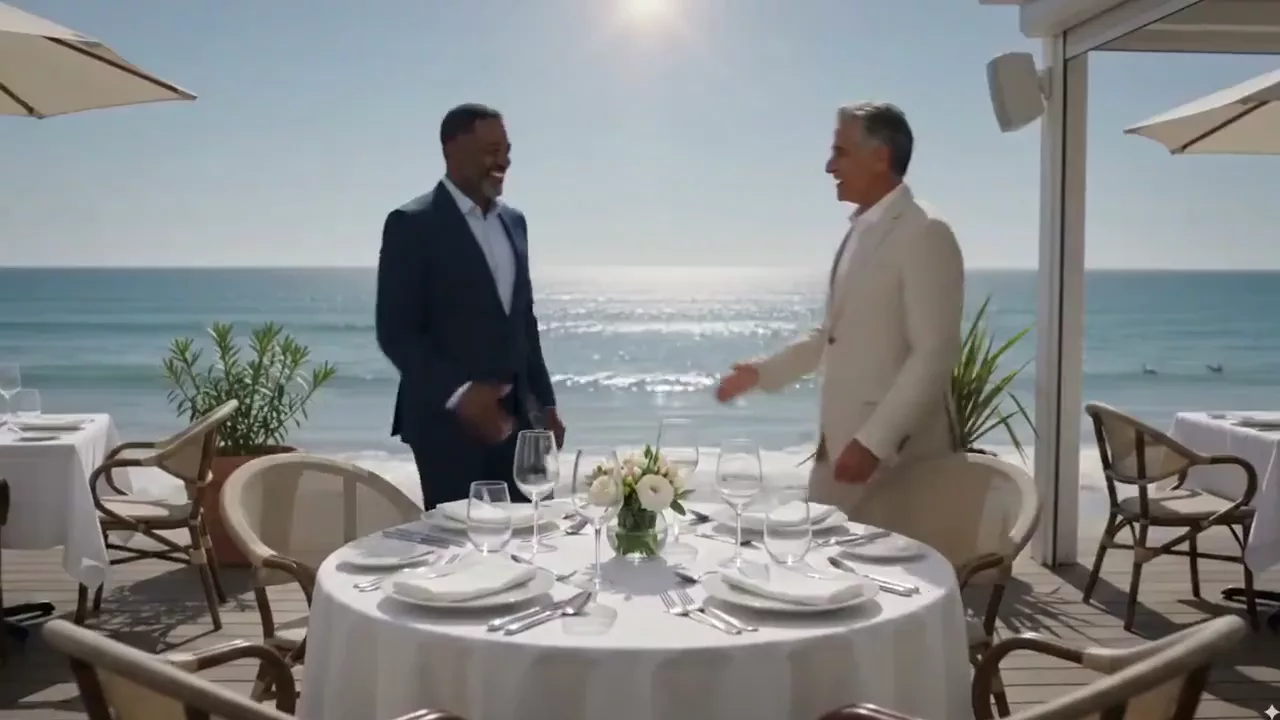
一致的视觉叙事
Gemini Omni 有助于解决 AI 视频最难的问题之一:让每个场景都保持一致且有意义。它可以追踪角色身份、场景细节、视觉风格和环境元素,让镜头彼此连贯;对文本和公式连贯性的增强,也让课程、教程、产品演示、动画和品牌叙事更实用。
基于知识的场景创作
Gemini Omni 将更广泛的知识和上下文理解引入视频生成,可以创建信息更充足、结构更清晰、意义更明确的场景。历史内容、教育讲解和产品演示都可以从这种逻辑更连贯的生成方式中受益。

精准音频控制
Gemini Omni 可以生成与画面意图、氛围和节奏相匹配的语音、环境声和音效。清晰对白、自然口型、空间化环境声与细微 Foley 细节共同服务于叙事,让视频从视觉片段发展为更完整的视听体验。

多样化镜头角度
Gemini Omni 支持在不同摄像机角度之间进行连贯切换。无论是戏剧性的俯拍、贴地视角还是正面到侧面的平滑转换,都可以用更明确的镜头语言来讲故事,也能帮助教学设计师制作更清晰的培训材料。

定制化数字人生成
你的数字形象完全由你掌控。Gemini Omni 可以根据参考图保持脸部、发型和整体身份一致,生成带有自然口型、面部表情和细微动作的个性化数字人;它适合讲述者、教育者和 VTuber,也适合希望保持现实身份隐私的创作者。

Gemini Omni 适合哪些创作者?
从广告预演到教育内容,Gemini Omni 的多模态输入和视频编辑方向可以服务不同规模的创作团队。
电影制作人与广告公司
制作原型、预演、专业级 TVC 广告、产品片和电影预告片。
内容创作者
生成 Reels、Shorts、TikTok、品牌故事和角色一致、音频丰富的社交视频。
营销人员
简化宣传视频和产品可视化制作,用更快的重混与编辑流程迭代品牌内容。
教育工作者
制作讲解、培训和课程视频,把复杂概念转化为清晰的视觉叙事。
机构与工作室
使用多模态参考、精准创意控制和高分辨率输出构建更完整的专业工作流。
如何在 AnyAIHub 上使用 Gemini Omni
按照选择模型、输入创意、设置参数并生成下载的流程,把参考素材转化为视频。
1
1. 选择 Gemini Omni
打开 AnyAIHub 视频生成器,在模型选择器中选择 Gemini Omni。
2
2. 输入提示词和参考素材
描述要生成或编辑的视频,并按需上传图片或视频作为人物、场景、风格或运动参考。最多可使用 7 个参考配额,其中一个视频占用 2 个配额。
3
3. 设置参数并下载结果
选择 16:9 或 9:16、4/6/8/10 秒以及 720p、1080p 或 4K,提交生成后预览并下载视频。
FAQs
了解 Gemini Omni 的模型定位、与 Veo 3 的差异、输入方式、输出规格和 AnyAIHub 积分规则。
什么是 Gemini Omni?
Gemini Omni 是 Google 的多模态 AI 视频模型,用于创建和编辑视频。它可以理解提示词、图片和视频参考,并通过视频重混、一致的视觉叙事和知识型场景创作,把视频生成变成更连贯的创作流程。
Gemini Omni 与 Veo 3 有什么不同?
Gemini Omni 更强调多模态参考、现有视频编辑与重混、角色和物体的一致性、电影级镜头控制以及更丰富的音频方向。AnyAIHub 当前开放的 Gemini Omni 参数为 4/6/8/10 秒、720p/1080p/4K 和 16:9/9:16。
Gemini Omni 在 AnyAIHub 上可以免费使用吗?
AnyAIHub 使用积分提交生成任务,是否能免费体验取决于账户当前可用积分和站点活动。提交前会在生成器中显示对应参数所需的积分,不会把第三方平台的免费试用承诺带到 AnyAIHub。
Gemini Omni 适合初学者吗?
适合。你可以从一句自然语言提示词开始,也可以上传图片或视频参考,不需要先掌握时间线剪辑。复杂的多参考创作需要一些练习,但基本流程是选择模型、描述意图、设置参数并生成。
Gemini Omni 的精准音频功能如何工作?
提示词可以指定对白、口型同步、环境声、音效和整体氛围。模型会尝试让这些声音与画面动作和镜头节奏保持一致;最终效果仍取决于提示词、参考素材和上游模型输出。
Gemini Omni 支持哪些输入?
AnyAIHub 当前接入支持提示词、最多 7 个参考配额的图片,或 1 个视频与剩余图片配额的组合。一个视频占用 2 个配额,一张图片占用 1 个配额,总配额不能超过 7。
Gemini Omni 支持多长的视频和哪些分辨率?
当前无视频参考时可以选择 4、6、8 或 10 秒,并支持 720p、1080p 和 4K;画幅支持 16:9 和 9:16。上传视频参考后,输出时长由模型工作流处理。
Gemini Omni 如何计算积分?
当前视频生成积分按分辨率和时长计算:720p 为 4/6/8/10 秒 80/130/180/230 积分,1080p 为 90/140/190/240 积分,4K 为 250/400/450/500 积分。具体价格以提交时生成器显示为准。
立即体验 Gemini Omni,创作、编辑并重混 AI 视频
从一条提示词或一组参考素材开始,用 AnyAIHub 把多模态创意转化为支持原生音频和最高 4K 输出的视频。