Modelle
- Seedance 2.5BeliebtNeu
- Seedance 2.0Beliebt
- MiniMax H3Neu
- Veo 3.1 PremiumBeliebt
- GPT Image 2Neu
- Nano Banana 2
- Nano Banana ProBeliebt
- Seedream 5.0 Pro
- Grok Imagine Image 2.0
- Z-Image Turbo
Laden...
Gemini Omni ist Googles Familie multimodaler Videomodelle zum Erstellen, Bearbeiten und Remixen von Videos. Text, Bilder, Videoclips und kreative Vorgaben fließen in einer einzigen Anweisung zusammen. So kannst du mit einer Idee beginnen und sie Schritt für Schritt zu einem vollständigeren, stimmigeren Video ausarbeiten.
Die folgenden Beispiele zeigen die wichtigsten kreativen Einsatzfelder von Gemini Omni: einheitliche multimodale Eingaben, Bearbeitung in natürlicher Sprache, Video-Remixing, gezielte Szenenänderungen, konsistentes visuelles Storytelling, wissensbasierte Szenen, präziser Ton, verschiedene Kamerawinkel und individuelle digitale Avatare.
Gemini Omni ist nicht auf einen einzigen Eingabetyp beschränkt. Beschreibe das Konzept per Text, definiere den visuellen Stil mit Bildern, gib Bewegungen durch Videoclips vor und lege die Gesamtstimmung über den Ton fest. Das Modell versteht die verschiedenen Referenzen als eine zusammenhängende kreative Anweisung und erzeugt so präzisere, ausdrucksstärkere Videos, die besser zu deiner Idee passen.

Gemini Omni macht die Bearbeitung zum Dialog. Du musst weder eine Timeline anpassen noch Szenen manuell schneiden oder einen Clip von Grund auf neu erstellen. Beschreibe einfach die gewünschte Änderung, und das Modell überarbeitet das Video nach deiner Anweisung. So wird aus einer komplexen Bearbeitung ein klarer Satz.
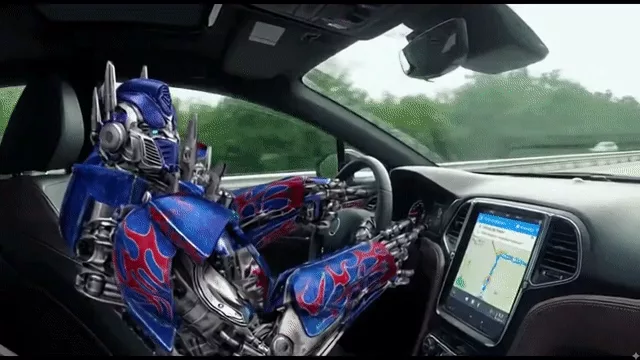
Mit Gemini Omni kannst du vorhandene Videos weiterentwickeln, statt jedes Mal von vorn anzufangen. Mehrere Clips lassen sich zu einer neuen Version verbinden, während ihre ursprüngliche Struktur oder kreative Richtung erhalten bleibt. So gelangen Werbevarianten, Produktpräsentationen und Lifestyle-Inhalte schneller in die nächste Runde.
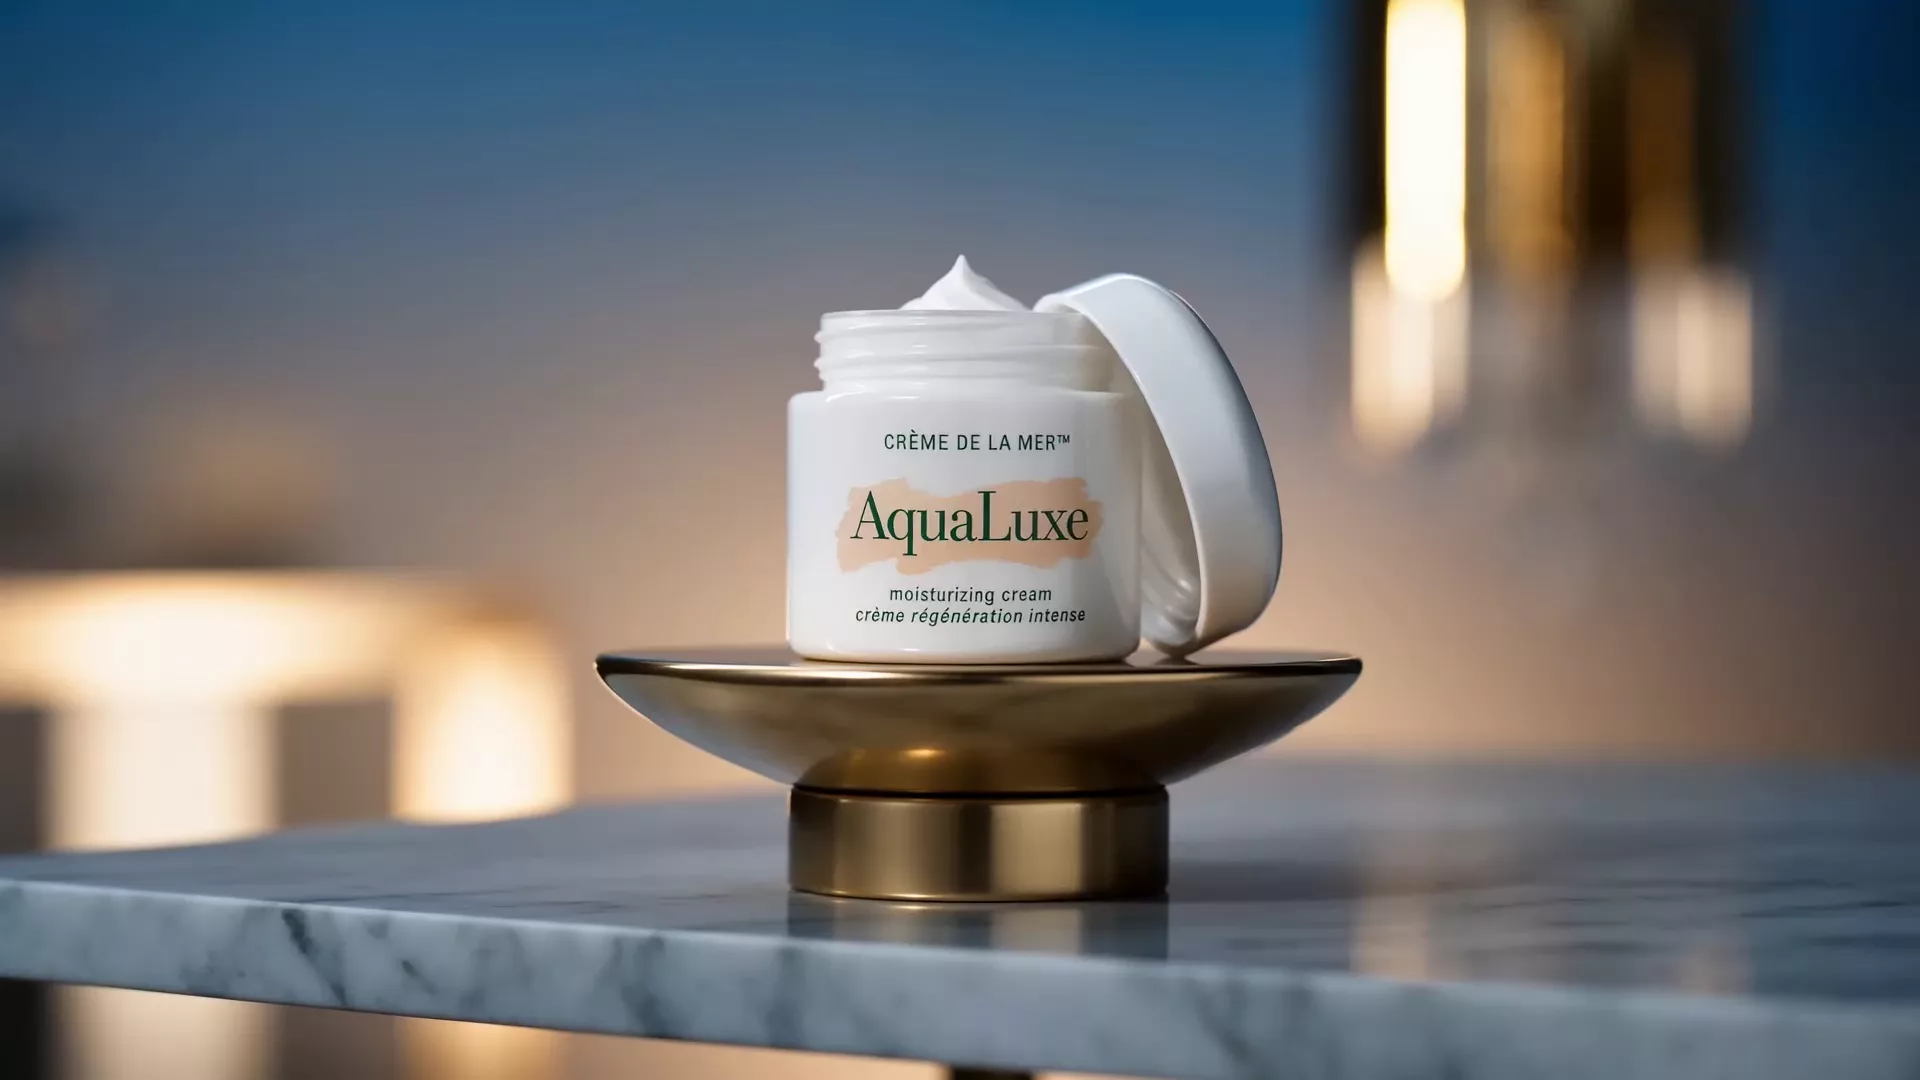
Gemini Omni ermöglicht präzise Änderungen innerhalb eines bestehenden Videos. Anstatt die gesamte Szene neu zu generieren, konzentrierst du dich auf das Objekt oder Detail, das verbessert werden soll. Kleine Fehler lassen sich korrigieren, während ursprüngliche Komposition, Bewegung und Gesamtstil möglichst erhalten bleiben.
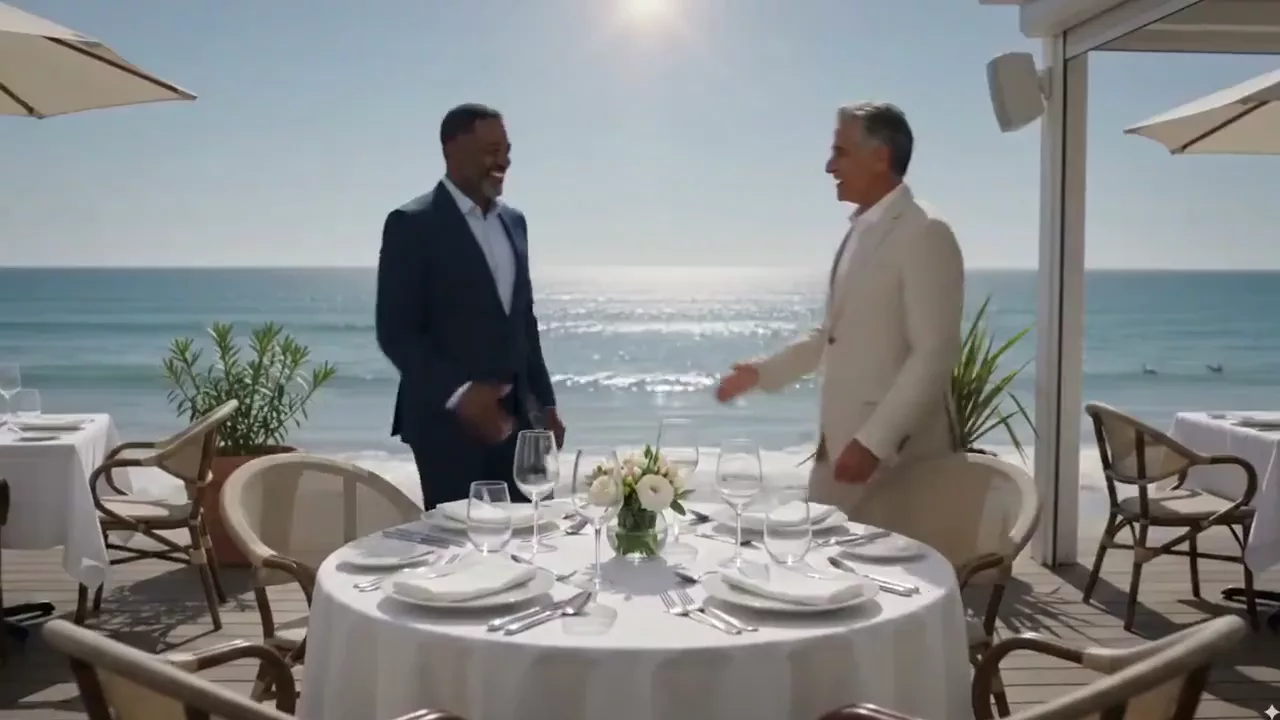
Gemini Omni hilft bei einer der größten Herausforderungen von KI-Videos: Jede Szene konsistent und sinnvoll zu halten. Das Modell kann Figurenidentität, Szenendetails, visuellen Stil und Umgebungselemente nachverfolgen, damit die Einstellungen zusammenpassen. Eine bessere Kontinuität bei Text und Formeln macht es zudem praktischer für Unterricht, Tutorials, Produktvorführungen, Animationen und Markengeschichten.
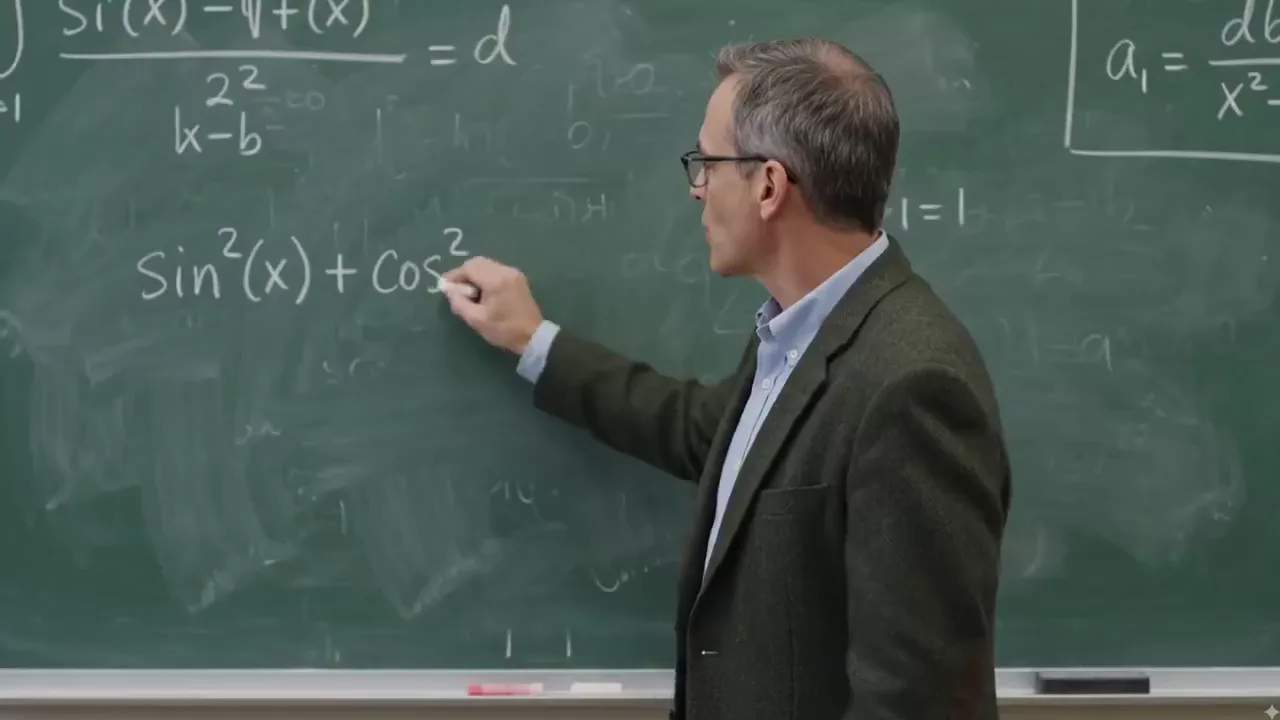
Gemini Omni bringt breiteres Wissen und Kontextverständnis in die Videogenerierung ein. Dadurch entstehen informativere, klarer strukturierte und leichter verständliche Szenen. Historische Inhalte, pädagogische Erklärvideos und Produktvorführungen profitieren von dieser logisch stimmigeren Erstellungsweise.

Gemini Omni kann Sprache, Umgebungsgeräusche und Soundeffekte erzeugen, die zu Bildaussage, Atmosphäre und Rhythmus passen. Klarer Dialog, natürliche Lippenbewegungen, räumlicher Umgebungston und dezente Foley-Details unterstützen gemeinsam die Erzählung und machen aus einem visuellen Clip ein vollständigeres audiovisuelles Erlebnis.

Gemini Omni unterstützt stimmige Übergänge zwischen verschiedenen Kamerawinkeln. Ob dramatische Aufsicht, bodennahe Perspektive oder fließender Wechsel von vorn zur Seite: Eine klarere Bildsprache unterstützt die Erzählung und hilft Instructional Designern, verständlichere Schulungsmaterialien zu erstellen.

Dein digitales Abbild bleibt vollständig unter deiner Kontrolle. Anhand eines Referenzbildes kann Gemini Omni Gesicht, Frisur und Gesamtidentität konsistent halten und einen personalisierten digitalen Avatar mit natürlicher Lippensynchronität, Gesichtsausdrücken und dezenten Bewegungen erzeugen. Das eignet sich für Erzähler, Lehrkräfte und VTuber ebenso wie für Kreative, die ihre reale Identität schützen möchten.

Von der Werbe-Previsualisierung bis zu Bildungsinhalten können die multimodalen Eingaben und Videobearbeitungsfunktionen von Gemini Omni Kreativteams unterschiedlicher Größe unterstützen.
Erstelle Prototypen, Previsualisierungen, professionelle TV-Werbespots, Produktfilme und Kinotrailer.
Erstelle Reels, Shorts, TikTok-Videos, Markengeschichten und Social-Media-Videos mit konsistenten Figuren und vielschichtigem Ton.
Vereinfache die Produktion von Werbevideos und Produktvisualisierungen und entwickle Markeninhalte mit schnelleren Remix- und Bearbeitungsabläufen weiter.
Erstelle Erklär-, Schulungs- und Kursvideos, die komplexe Konzepte in klare visuelle Geschichten verwandeln.
Baue mit multimodalen Referenzen, präziser kreativer Kontrolle und hochauflösender Ausgabe einen umfassenderen professionellen Workflow auf.
Wandle Referenzmaterial in Videos um: Wähle das Modell, beschreibe deine Idee, lege die Parameter fest und generiere das Ergebnis zum Herunterladen.
Öffne den AnyAIHub-Videogenerator und wähle Gemini Omni in der Modellauswahl aus.
Beschreibe das Video, das du erstellen oder bearbeiten möchtest, und lade bei Bedarf Bilder oder ein Video als Referenz für Person, Szene, Stil oder Bewegung hoch. Du kannst bis zu 7 Referenzplätze nutzen; ein Video belegt davon 2.
Wähle 16:9 oder 9:16, eine Dauer von 4/6/8/10 Sekunden und 720p, 1080p oder 4K. Starte die Generierung, sieh dir das Ergebnis in der Vorschau an und lade das Video herunter.
Informiere dich über die Positionierung von Gemini Omni, die Unterschiede zu Veo 3, unterstützte Eingaben, Ausgabespezifikationen und die AnyAIHub-Guthabenregeln.
Gemini Omni ist Googles multimodales KI-Videomodell zum Erstellen und Bearbeiten von Videos. Es versteht Prompts, Bilder und Videoreferenzen und verbindet Video-Remixing, konsistentes visuelles Storytelling und wissensbasierte Szenenerstellung zu einem stimmigeren kreativen Workflow.
Gemini Omni legt mehr Wert auf multimodale Referenzen, die Bearbeitung und das Remixing vorhandener Videos, konsistente Figuren und Objekte, filmische Kamerasteuerung und vielfältigere Audiovorgaben. AnyAIHub unterstützt für Gemini Omni derzeit 4/6/8/10 Sekunden, 720p/1080p/4K sowie die Seitenverhältnisse 16:9/9:16.
AnyAIHub verwendet Guthaben, um Generierungsaufträge einzureichen. Ob du Gemini Omni kostenlos testen kannst, hängt von deinem aktuell verfügbaren Kontoguthaben und laufenden Aktionen ab. Vor dem Absenden zeigt der Generator den Guthabenbedarf für die gewählten Parameter an; kostenlose Testangebote anderer Plattformen gelten nicht für AnyAIHub.
Ja. Du kannst mit einem Prompt in natürlicher Sprache beginnen oder ein Bild beziehungsweise Video als Referenz hochladen, ohne zuvor Timeline-Bearbeitung lernen zu müssen. Komplexe Projekte mit mehreren Referenzen erfordern etwas Übung, doch der Grundablauf bleibt einfach: Modell wählen, Absicht beschreiben, Parameter festlegen und generieren.
Im Prompt kannst du Dialog, Lippensynchronität, Umgebungsgeräusche, Soundeffekte und die Gesamtstimmung festlegen. Das Modell versucht, diese Klänge mit den Bildbewegungen und dem Schnittrhythmus abzustimmen; das endgültige Ergebnis hängt weiterhin vom Prompt, dem Referenzmaterial und der Ausgabe des zugrunde liegenden Modells ab.
Die aktuelle AnyAIHub-Integration unterstützt Prompts, bis zu 7 mit Bildern belegte Referenzplätze oder eine Kombination aus 1 Video und Bildern auf den verbleibenden Plätzen. Ein Video belegt 2 Plätze, ein Bild 1 Platz; insgesamt dürfen es höchstens 7 sein.
Ohne Videoreferenz kannst du derzeit 4, 6, 8 oder 10 Sekunden sowie 720p, 1080p oder 4K auswählen; unterstützt werden die Seitenverhältnisse 16:9 und 9:16. Wenn du eine Videoreferenz hochlädst, bestimmt der Modell-Workflow die Ausgabedauer.
Das Guthaben für die Videogenerierung wird derzeit nach Auflösung und Dauer berechnet: 720p kostet für 4/6/8/10 Sekunden 80/130/180/230 Guthabenpunkte, 1080p kostet 90/140/190/240 und 4K kostet 250/400/450/500. Maßgeblich ist der Preis, den der Generator beim Absenden anzeigt.
Beginne mit einem Prompt oder einer Reihe von Referenzmaterialien und verwandle deine multimodale Idee mit AnyAIHub in ein Video mit nativem Ton und einer Ausgabe bis 4K.