로딩 중...
Gemini Omni
Gemini Omni AI 동영상 생성기
프롬프트, 이미지 레퍼런스, 동영상 클립으로 AI 동영상을 제작하고 편집하고 리믹스하세요
Gemini Omni는 동영상 제작, 편집, 리믹스를 위한 Google의 멀티모달 동영상 모델 제품군입니다. 텍스트, 이미지, 동영상 클립, 창작 방향을 하나의 지시에 담아 아이디어 하나에서 시작해 더 완성도 높고 일관된 동영상으로 단계적으로 발전시킬 수 있습니다.
Gemini Omni의 예상 기능
아래 예시는 Gemini Omni의 핵심 창작 방향을 보여 줍니다. 통합 멀티모달 입력, 자연어 편집, 동영상 리믹스, 대상 장면 수정, 일관된 시각적 스토리텔링, 지식 기반 장면, 정밀한 오디오, 다양한 카메라 앵글, 맞춤형 디지털 아바타를 다룹니다.
네이티브 멀티모달 동영상 생성
Gemini Omni는 한 가지 입력 유형에만 제한되지 않습니다. 텍스트로 콘셉트를 설명하고, 이미지로 시각적 스타일을 정하고, 동영상 클립으로 움직임을 제안하고, 오디오로 전체 분위기를 설정하세요. 모델은 이러한 레퍼런스를 하나의 일관된 창작 지시로 해석해 더 정확하고 표현력 있으며 의도에 가까운 동영상을 생성합니다.

자연어 동영상 편집
Gemini Omni는 편집을 대화처럼 바꿔 줍니다. 타임라인을 조정하거나 장면을 수동으로 자르거나 클립을 처음부터 다시 만들 필요가 없습니다. 바꾸고 싶은 내용을 설명하면 모델이 지시에 따라 동영상을 수정해 복잡한 편집 의도를 명확한 한 문장으로 줄여 줍니다.
동영상 리믹스
Gemini Omni를 사용하면 매번 처음부터 시작하지 않고 기존 동영상을 바탕으로 이어서 제작할 수 있습니다. 여러 클립을 원래 구조나 창작 방향을 유지한 새 버전으로 결합해 광고 수정, 제품 소개, 라이프스타일 콘텐츠를 더 빠르게 다음 단계로 발전시키세요.
대상 장면 편집
Gemini Omni는 기존 동영상 안에서 정밀한 편집을 지원합니다. 장면 전체를 다시 생성하는 대신 개선할 객체나 세부 요소에 집중해 원래 구도와 움직임, 전체 스타일을 최대한 유지하면서 작은 문제를 수정할 수 있습니다.
일관된 시각적 스토리텔링
Gemini Omni는 AI 동영상의 가장 어려운 과제 중 하나인 모든 장면의 일관성과 의미를 유지하는 일을 돕습니다. 캐릭터의 정체성, 장면 세부 정보, 시각적 스타일, 환경 요소를 추적해 쇼트가 서로 자연스럽게 이어지도록 합니다. 텍스트와 수식의 연속성도 개선되어 수업, 튜토리얼, 제품 시연, 애니메이션, 브랜드 스토리에 더 실용적입니다.
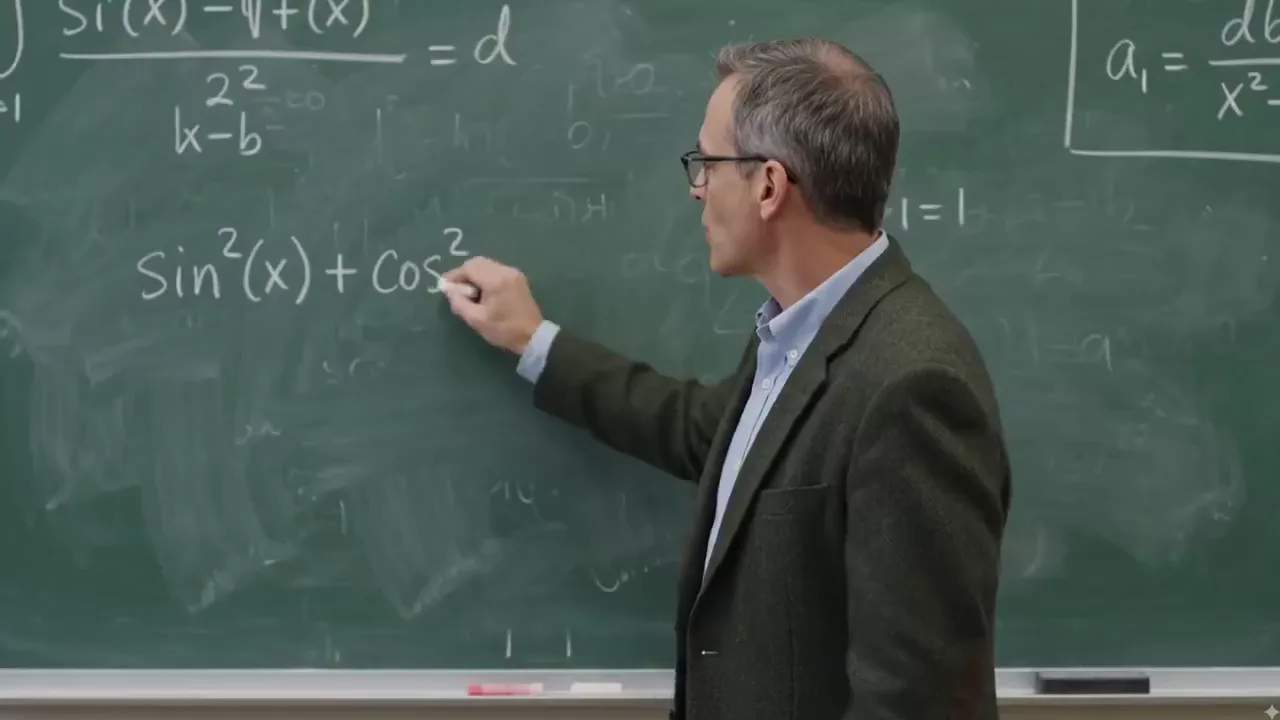
지식 기반 장면 생성
Gemini Omni는 폭넓은 지식과 맥락 이해를 동영상 생성에 더해 정보가 풍부하고 구조가 명확하며 이해하기 쉬운 장면을 만들 수 있습니다. 역사 콘텐츠, 교육용 설명, 제품 시연은 이러한 논리적으로 일관된 접근의 이점을 얻을 수 있습니다.

정밀한 오디오 제어
Gemini Omni는 시각적 의도와 분위기, 리듬에 맞는 음성, 환경음, 효과음을 생성할 수 있습니다. 명확한 대사, 자연스러운 립싱크, 공간감 있는 환경음, 섬세한 폴리 사운드가 이야기를 함께 뒷받침해 시각 클립을 더 완성도 높은 오디오비주얼 경험으로 확장합니다.

다양한 카메라 앵글
Gemini Omni는 서로 다른 카메라 앵글 사이를 일관되게 전환할 수 있습니다. 극적인 오버헤드 샷, 지면에 가까운 시점, 정면에서 측면으로의 부드러운 전환 등 더 명확한 영상 언어로 이야기를 전달하고 교육 설계자가 효과적인 교육 자료를 만드는 데 도움을 줍니다.

맞춤형 디지털 아바타 생성
디지털 모습은 사용자가 직접 관리합니다. 레퍼런스 이미지를 사용하면 Gemini Omni가 얼굴, 헤어스타일, 전체 정체성을 일관되게 유지하면서 자연스러운 립싱크, 표정, 섬세한 움직임을 갖춘 개인화 아바타를 만들 수 있습니다. 스토리텔러, 교육자, VTuber, 실제 신원을 보호하고 싶은 크리에이터에게 적합합니다.

Gemini Omni는 누구에게 적합한가요?
광고 프리비주얼라이제이션부터 교육 콘텐츠까지, Gemini Omni의 멀티모달 입력과 동영상 편집 지시는 규모가 다른 창작팀을 지원할 수 있습니다.
영상 제작자와 광고 대행사
프로토타입, 프리비주얼라이제이션, 전문 TV 광고, 제품 영상, 영화 예고편을 제작하세요.
콘텐츠 크리에이터
Reels, Shorts, TikTok 동영상, 브랜드 스토리, 풍부한 오디오와 일관된 캐릭터를 갖춘 소셜 동영상을 생성하세요.
마케터
프로모션 동영상과 제품 시각화를 간소화하고, 리믹스 및 편집 워크플로를 통해 브랜드 콘텐츠를 더 빠르게 반복 제작하세요.
교육자
복잡한 개념을 명확한 시각적 스토리로 바꾸는 설명 영상, 교육 자료, 강의 동영상을 제작하세요.
에이전시와 스튜디오
멀티모달 레퍼런스, 정밀한 창작 제어, 고해상도 출력을 활용해 더 완성도 높은 전문 워크플로를 구축하세요.
AnyAIHub에서 Gemini Omni를 사용하는 방법
모델을 선택하고 창작 방향을 입력한 뒤 매개변수를 설정해 레퍼런스 자료를 동영상으로 변환하고 결과를 다운로드하세요.
1
1. Gemini Omni 선택
AnyAIHub 동영상 생성기를 열고 모델 선택기에서 Gemini Omni를 선택하세요.
2
2. 프롬프트와 레퍼런스 자료 추가
생성하거나 편집할 동영상을 설명한 다음 필요에 따라 캐릭터, 장면, 스타일, 움직임의 레퍼런스로 이미지나 동영상을 업로드하세요. 최대 7개의 레퍼런스 슬롯을 사용할 수 있으며 동영상은 2개 슬롯을 차지합니다.
3
3. 매개변수 설정 및 다운로드
16:9 또는 9:16, 4/6/8/10초, 720p·1080p·4K를 선택하세요. 생성을 제출하고 결과를 미리 본 다음 동영상을 다운로드하세요.
자주 묻는 질문
Gemini Omni의 모델 포지셔닝, Veo 3와의 차이, 지원 입력, 출력 사양, AnyAIHub 크레딧 규칙을 알아보세요.
Gemini Omni란 무엇인가요?
Gemini Omni는 동영상 제작과 편집을 위한 Google의 멀티모달 AI 동영상 모델입니다. 프롬프트, 이미지, 동영상 레퍼런스를 이해하고 동영상 리믹스, 일관된 시각적 스토리텔링, 지식 기반 장면 생성을 더 일관된 창작 워크플로에 결합합니다.
Gemini Omni는 Veo 3와 어떻게 다른가요?
Gemini Omni는 멀티모달 레퍼런스, 기존 동영상의 편집 및 리믹스, 캐릭터와 객체의 일관성, 영화적 카메라 제어, 풍부한 오디오 지시에 더 큰 비중을 둡니다. AnyAIHub의 Gemini Omni는 현재 4/6/8/10초 동영상, 720p/1080p/4K 출력, 16:9/9:16 화면 비율을 지원합니다.
AnyAIHub에서 Gemini Omni를 무료로 사용할 수 있나요?
AnyAIHub는 크레딧을 사용해 생성 작업을 제출합니다. Gemini Omni를 무료로 사용해 볼 수 있는지는 계정의 현재 크레딧과 사이트의 진행 중인 프로모션에 따라 달라집니다. 제출 전에 생성기가 선택한 매개변수에 필요한 크레딧을 표시하며, 타사 플랫폼의 무료 체험은 AnyAIHub에 적용되지 않습니다.
Gemini Omni는 초보자에게도 적합한가요?
네. 자연어 프롬프트로 시작하거나 이미지 또는 동영상 레퍼런스를 업로드할 수 있어 타임라인 편집을 먼저 배울 필요가 없습니다. 여러 레퍼런스를 사용하는 복잡한 제작에는 연습이 필요하지만 기본 흐름은 모델을 선택하고 의도를 설명하고 매개변수를 설정한 뒤 생성하는 것입니다.
Gemini Omni의 정밀 오디오 기능은 어떻게 작동하나요?
프롬프트에서 대사, 립싱크, 환경음, 효과음, 전체 분위기를 지정할 수 있습니다. 모델은 이러한 소리를 화면 속 동작과 동영상의 리듬에 맞추려고 하지만 최종 결과는 프롬프트, 레퍼런스 자료, 상위 모델의 출력에도 영향을 받습니다.
Gemini Omni는 어떤 입력을 지원하나요?
현재 AnyAIHub 연동은 프롬프트, 이미지로 채운 최대 7개의 레퍼런스 슬롯, 또는 1개의 동영상과 나머지 슬롯의 이미지를 조합한 입력을 지원합니다. 동영상은 2개 슬롯, 이미지는 1개 슬롯을 사용하며 총 한도는 7개입니다.
Gemini Omni는 어떤 동영상 길이와 해상도를 지원하나요?
동영상 레퍼런스를 제공하지 않으면 현재 4, 6, 8, 10초를 720p, 1080p 또는 4K로 선택할 수 있으며 화면 비율은 16:9와 9:16을 지원합니다. 동영상 레퍼런스를 업로드하면 출력 길이는 모델 워크플로에 따라 결정됩니다.
Gemini Omni 크레딧은 어떻게 계산되나요?
동영상 생성 크레딧은 현재 해상도와 길이에 따라 계산됩니다. 720p에서는 4/6/8/10초가 80/130/180/230크레딧, 1080p에서는 90/140/190/240크레딧, 4K에서는 250/400/450/500크레딧입니다. 제출할 때 생성기에 표시되는 가격이 최종 기준입니다.
Gemini Omni로 AI 동영상을 제작하고 편집하고 리믹스해 보세요
프롬프트나 레퍼런스 자료에서 시작해 AnyAIHub로 멀티모달 아이디어를 기본 오디오와 최대 4K 출력의 동영상으로 바꾸세요.